Title: Network intrusion detection using deep learning model
Author: Le Anh Quan, Tran Minh Quang, Ly Phuong Khai, Tran Trung Nguyen and Phan Thuong Cang
Affiliation: College of Information and Communication Technology, Can Tho University, Viet Nam
TÓM TẮT
Trong nghiên cứu này, việc phân tích hiệu suất của các mô hình học sâu trong phát hiện xâm nhập mạng dựa trên dữ liệu UNSW-NB15 đã được thực hiện. Các mô hình được triển khai bao gồm MLP, RNN, CNN, LSTM, BiLSTM, GRU, Autoencoder và Transformer. Kết quả cho thấy BiLSTM và GRU đạt độ chính xác cao nhất (98,78%) với thời gian huấn luyện ngắn (656,20 và 497,89 phút), trong khi Transformer cũng đạt độ chính xác cao (98,76%) nhưng yêu cầu thời gian huấn luyện dài nhất (1.010,49 phút). RNN và Autoencoder có thời gian huấn luyện ngắn nhất nhưng độ chính xác thấp hơn. BiLSTM và GRU là lựa chọn tối ưu nhờ sự cân bằng giữa độ chính xác và thời gian huấn luyện, Transformer phù hợp với hệ thống không giới hạn tài nguyên. Trong nghiên cứu, tiềm năng của các mô hình học sâu trong phát hiện các mối xâm nhập mạng hiện đại và khả năng ứng dụng vào các hệ thống an ninh mạng thực tiễn được nhấn mạnh.
Từ khóa: BiLSTM, GRU, học sâu, UNSW-NB15, phát hiện xâm nhập mạng, Transformer
ABSTRACT
This study analyzes the performance of deep learning models in network intrusion detection using the UNSW-NB15 dataset. The evaluated models include MLP, RNN, CNN, LSTM, BiLSTM, GRU, Autoencoder, and Transformer. Experimental results show that BiLSTM and GRU achieved the highest accuracy (98.78%) with relatively short training times (656.20 and 497.89 minutes). Meanwhile, the Transformer also achieved high accuracy (98.76%) but required the longest training time (1010.49 minutes). RNN and Autoencoder had the shortest training times but slightly lower accuracy (98.64% and 98.72%). BiLSTM and GRU emerged as optimal choices due to their balance between accuracy and training time, whereas Transformer is suitable for systems with abundant computational resources. This study highlights the potential of deep learning models in detecting modern network intrusions and their applicability to practical cybersecurity systems.
Keywords: BiLSTM, deep learning, GRU, intrusion detection, Transformer, UNSW-NB15
1. GIỚI THIỆU
An ninh mạng đã trở thành một thách thức lớn trong thời đại kỹ thuật số khi các cuộc tấn công ngày càng trở nên tinh vi và phức tạp. Hệ thống phát hiện xâm nhập mạng (IDS - Intrusion Detection System) là một trong những giải pháp chủ chốt để bảo vệ các hệ thống mạng khỏi các hành vi xâm nhập trái phép. Tuy nhiên, các phương pháp truyền thống thường gặp phải nhiều hạn chế, như tỷ lệ cảnh báo sai cao, độ chính xác không cao khi xử lý các dạng dữ liệu mạng phức tạp và khả năng thích ứng kém với các mối đe dọa mới. Việc ứng dụng các mô hình học sâu, một nhánh của trí tuệ nhân tạo, trong phát hiện xâm nhập mạng đã mở ra cơ hội nâng cao hiệu quả và độ chính xác. Ở các nghiên cứu trước đây, các kỹ thuật học sâu như CNN, RNN và LSTM đã được áp dụng trong phát hiện xâm nhập, nhưng chưa đánh giá đầy đủ về hiệu quả phân loại đa lớp và khả năng phát hiện các kiểu tấn công mới hoặc ít xuất hiện.
Trong nghiên cứu này, một loạt các mô hình học sâu đã được triển khai như RNN, Autoencoder, MLP, CNN, BiLSTM, LSTM, GRU và Transformer nhằm nâng cao khả năng nhận diện các hành vi xâm nhập trên tập dữ liệu UNSW-NB15. Tính mới của nghiên cứu nằm ở việc đánh giá toàn diện hiệu quả của các mô hình trong phân loại đa lớp các tấn công khác nhau, như Exploits, Fuzzers và Generic trên cùng một môi trường huấn luyện. Mục tiêu được đặt ra trong nghiên cứu là xác định mô hình tối ưu với độ chính xác cao nhất, giảm thiểu thời gian huấn luyện, và cải thiện khả năng phát hiện các loại tấn công mạng phức tạp.
2. CÁC NGHIÊN CỨU LIÊN QUAN
2.1. Các loại tấn công mạng
2.1.1. Analysis: Analysis là cuộc tấn công bằng cách thâm nhập ứng dụng web bằng chức năng quét cổng, thư rác và tập lệnh web (Moustafa & Slay, 2015).
2.1.2. DoS: DoS là loại tấn công làm gián đoạn, quá tải tài nguyên của một hệ thống hoặc dịch vụ thông qua bộ nhớ, khiến nó không thể phục vụ các yêu cầu vào hệ thống (Moustafa & Slay, 2015).
2.1.3. Exploit: Exploit là một chuỗi các hướng dẫn lợi dụng lỗi, sự cố, hoặc lỗ hổng bảo mật do hành vi không mong muốn hoặc không được dự đoán trên máy chủ hoặc mạng gây ra (Moustafa & Slay, 2015).
2.1.4. Fuzzers: Fuzzers Attack là một dạng tấn công mạng nhằm vào các hệ thống và máy chủ bằng cách sử dụng một lượng lớn dữ liệu ngẫu nhiên, hoặc “fuzz”, để làm tràn và gây sập hệ thống (More et al., 2024).
2.1.5. Generic: Generic là một loại tấn công không nhắm vào một hệ thống, ứng dụng, hoặc cấu trúc cụ thể, mà có thể áp dụng đối với nhiều loại hệ thống hoặc dịch vụ khác nhau (More et al., 2024).
2.1.6. Reconnaissance: Đây là loại xâm nhập nhằm thăm dò thông tin của mạng máy tính mục tiêu nhằm trốn tránh các bảo mật của nó (Moustafa & Slay, 2015).
2.1.7. Worms: Worm là loại xâm nhập sẽ tự nhân bản và lây lan dựa trên các mạng máy tính khác tùy thuộc vào các lỗi bảo mật trên máy mục tiêu (Moustafa & Slay, 2015).
2.1.8. Backdoor: Tấn công cửa sau trong học máy là khi kẻ tấn công cài đặt một cửa sau vào mô hình, cho phép mô hình thực hiện cả nhiệm vụ chính và phụ (Gao et al., 2020).
2.1.9. Shellcode: Shellcode là một loại xâm nhập mà kẻ tấn công bắt đầu bằng đoạn mã nhỏ để điều khiển máy bị xâm nhập (Moustafa & Slay, 2015).
2.2. Các giải pháp phát hiện xâm nhập mạng hiện có
Các nghiên cứu gần đây tập trung vào việc ứng dụng học sâu trên tập dữ liệu UNSW-NB15. Stein et al. (2024) sử dụng Transformer đạt độ chính xác 79,57% (nhị phân) và 74,24% (đa lớp). Psathas et al. (2024) đề xuất hệ thống lai kết hợp DNN, CNN, LSTM đạt 97,5% độ chính xác nhưng tốn nhiều tài nguyên. Pansari et al. (2024) dùng XGBoost kết hợp Random Forest đạt 95,18% (nhị phân) và 84,01% (đa lớp). More et al. (2024) dùng Random Forest đạt 98,63%. Điểm nổi bật của nghiên cứu này là thực hiện so sánh toàn diện giữa các mô hình học sâu trong cùng một môi trường thử nghiệm công bằng và các siêu tham số đồng nhất.
2.3. Simple Imputer
Phương pháp giúp thay thế giá trị thiếu bằng các chiến lược như mean, median, most frequent (Bertsimas et al., 2021). Công thức: $$\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i \tag{1}$$ Trong đó $x_i$ là các giá trị quan sát được, $n$ là số lượng giá trị.
2.4. Log Transformation
Biến đổi dữ liệu lệch về phân phối chuẩn (Feng et al., 2014): $$\log(x) = \log_e(x + 1)$$
2.5. Isolation Forest
Phát hiện điểm bất thường dựa trên nguyên tắc cách ly (Liu et al., 2012). Độ sâu điều chỉnh: $$c(n) = 2H(n - 1) - \frac{2(n - 1)}{n} \tag{2}$$ Điểm cách ly: $$s(x, n) = 2^{-\frac{E(h(x))}{c(n)}} \tag{3}$$
2.6. Focal Loss
Giúp giải quyết mất cân bằng lớp bằng cách tập trung vào các mẫu khó: $$FL(p_t) = -\alpha_t (1 - p_t)^\gamma \log(p_t) \tag{4}$$
2.7. Standard Scaler
Chuẩn hóa Z-score (de Amorim et al., 2022): $$Z = \frac{X - \mu}{\sigma} \tag{5}$$
2.8. Tập dữ liệu
Bộ dữ liệu UNSW-NB15 gồm 2.540.044 bản ghi với 49 đặc trưng và 9 loại tấn công cùng lớp bình thường (Normal).
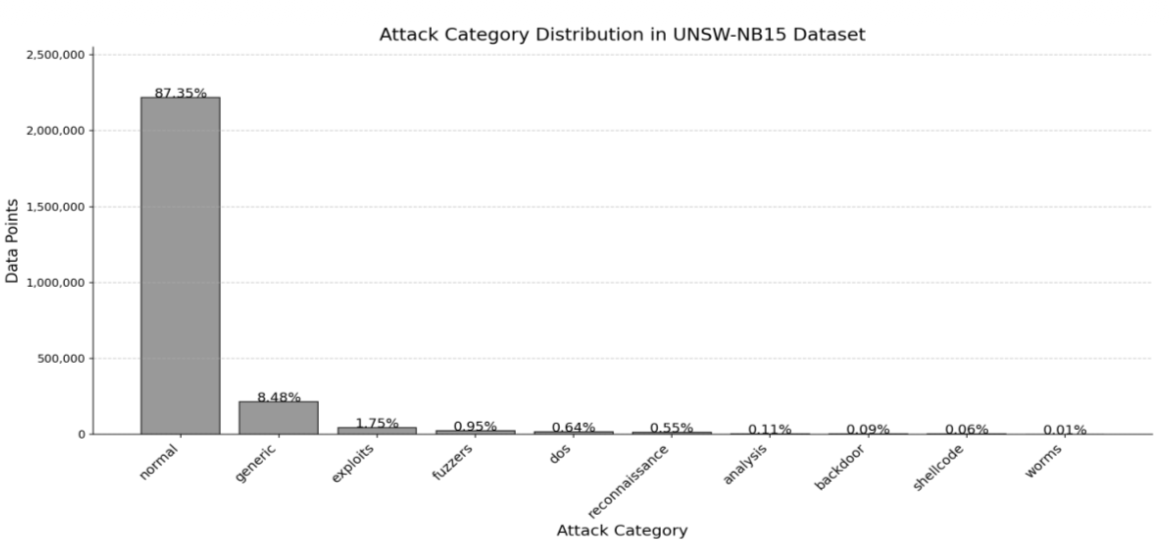
Hình 1. Phân bố mẫu các loại tấn công trong tập dữ liệu UNSW-NB15
2.9. Đặc trưng dữ liệu
Bảng 1. Đặc trưng luồng (Flow features)
| Tên | Mô tả |
|---|---|
| srcip | Địa chỉ IP nguồn |
| sport | Số cổng nguồn |
| dstip | Địa chỉ IP đích |
| dsport | Số cổng đích |
| proto | Giao thức giao dịch |
Bảng 2. Đặc trưng cơ bản và nội dung (Basic & Content features)
| Tên | Mô tả | Tên | Mô tả |
|---|---|---|---|
| state | Trạng thái giao thức | dur | Tổng thời gian |
| sbytes | Byte từ nguồn đến đích | dbytes | Byte từ đích tới nguồn |
| sttl | TTL từ nguồn tới đích | dttl | TTL từ đích tới nguồn |
| sloss | Gói nguồn bị mất | dloss | Gói đích bị mất |
| service | Dịch vụ (http, ftp, ...) | sload | Số bit/giây nguồn |
| dsload | Số bit/giây đích | spkts | Số gói từ nguồn |
| dpkts | Số gói từ đích | swin | Cửa sổ TCP nguồn |
| dwin | Cửa sổ TCP đích | stcpb | Số thứ tự TCP nguồn |
Bảng 3. Đặc trưng thời gian (Time features)
| Tên | Mô tả | Tên | Mô tả |
|---|---|---|---|
| sjit | Độ dao động nguồn | djit | Độ dao động đích |
| stime | Thời gian bắt đầu | ltime | Thời gian kết thúc |
| sintpkt | Thời gian giữa các gói nguồn | dintpkt | Thời gian giữa các gói đích |
| tcprtt | Tổng SYN-ACK + ACK-DAT | synack | Thời gian SYN đến SYN-ACK |
| ackdat | Thời gian SYN-ACK đến ACK |
Bảng 4. Đặc trưng bổ sung và Nhãn (Additional & Label features)
| Tên | Mô tả |
|---|---|
| is_sm_ips_ports | 1 nếu srcip=dstip và sport=dsport, ngược lại 0 |
| ct_state_ttl | Số lượng cho mỗi trạng thái theo khoảng sttl và dttl |
| ct_flw_http_mthd | Số luồng HTTP phương thức Get/Post |
| is_ftp_login | 1 nếu truy cập FTP có đăng nhập, ngược lại 0 |
| ct_ftp_cmd | Số lượng lệnh trong phiên FTP |
| ct_srv_src | Số bản ghi cùng service và srcip trong 100 bản ghi |
| ct_srv_dst | Số kết nối cùng service và dstip trong 100 kết nối |
| ct_dst_ltm | Số kết nối cùng dstip trong 100 kết nối |
| ct_src_ltm | Số kết nối cùng srcip trong 100 kết nối |
| ct_src_dport_ltm | Số kết nối cùng srcip và dsport trong 100 kết nối |
| ct_dst_sport_ltm | Số kết nối cùng dstip và sport trong 100 kết nối |
| ct_dst_src_ltm | Số kết nối cùng srcip và dstip trong 100 kết nối |
| attack_cat | Tên lớp tấn công |
| label | 0: bình thường, 1: tấn công |
3. MÔ HÌNH ĐỀ XUẤT
Quy trình nghiên cứu bao gồm tiền xử lý dữ liệu, chuẩn hóa, huấn luyện các mô hình học sâu (MLP, RNN, CNN, Autoencoder, LSTM, BiLSTM, GRU, Transformer) với Focal Loss ($\alpha=1, \gamma=2$).
Hình 2. Sơ đồ quy trình hoạt động của hệ thống
3.1. Tiền xử lý dữ liệu
Làm sạch, xử lý giá trị khuyết bằng Simple Imputer, biến đổi log, tạo đặc trưng mới, loại bỏ ngoại lệ bằng Isolation Forest (tỷ lệ 0,01), chia dữ liệu 80/20 và chuẩn hóa bằng StandardScaler.
3.2. Mô hình học sâu
Triển khai 8 kiến trúc bao gồm MLP, RNN, Autoencoder, CNN, LSTM, Transformer, BiLSTM và GRU.
3.3. Xử lý mất cân bằng dữ liệu
Sử dụng hàm tổn thất Focal Loss để tập trung vào các mẫu khó phân loại thay vì thay đổi phân bố dữ liệu ban đầu.
3.4. Các phương pháp đánh giá
Sử dụng các chỉ số Accuracy, Precision, Recall, F1-Score, Training Loss, Validation Loss, Training Time và AUC-ROC.
4. KẾT QUẢ VÀ THẢO LUẬN
4.1. Thiết lập thực nghiệm
Hệ thống CPU 20 nhân, RAM 48GB, GPU NVIDIA Tesla P40 (24GB VRAM), SSD 512GB trên nền tảng Linux.
4.2. Kết quả
BiLSTM và GRU đạt độ chính xác cao nhất (98,78%), F1-score đạt 98,64%. Transformer đạt Accuracy 98,76% nhưng thời gian huấn luyện dài nhất (1.010,49 phút). GRU và BiLSTM cho thấy sự cân bằng xuất sắc giữa thời gian huấn luyện và độ chính xác.